Kiểm tra AI crawler có đọc được site không: robots.txt, HTML ban đầu và log server
Tuần trước một người quen nhờ mình xem vì sao ChatGPT trả lời về công ty anh ấy toàn thông tin cũ. Nội dung không sai, schema cũng có. Kiểm tra một lúc mới ra nguyên nhân rất "dev": robots.txt đang
Các user-agent nên biết
</h2> <p>Không có danh sách nào đầy đủ mãi, nhưng đây là những cái mình hay gặp nhất:</p> <ul> <li> <strong>GPTBot</strong> (OpenAI): thu thập nội dung có thể dùng để huấn luyện mô hình. Chặn GPTBot nghĩa là bạn không muốn nội dung bị dùng cho việc đó.</li> <li> <strong>OAI-SearchBot</strong> (OpenAI): dùng cho tính năng tìm kiếm của ChatGPT. Theo tài liệu của OpenAI, site chặn bot này sẽ không xuất hiện trong câu trả lời tìm kiếm của ChatGPT (vẫn có thể hiện dạng link điều hướng).</li> <li> <strong>ChatGPT-User</strong> (OpenAI): truy cập khi người dùng yêu cầu ChatGPT mở một trang. OpenAI ghi rõ đây là hành động do người dùng khởi tạo nên robots.txt có thể không áp dụng.</li> <li> <strong>ClaudeBot</strong> (Anthropic) và <strong>PerplexityBot</strong> (Perplexity): crawler của hai nền tảng này.</li> <li> <strong>Google-Extended</strong>: chỉ là một token trong robots.txt, không có user-agent riêng nên bạn sẽ không thấy nó trong log. Google dùng nó để bạn chọn có cho nội dung phục vụ Gemini hay không; nó không ảnh hưởng tới việc trang có lên Google Search. AI Overviews vẫn đi theo Googlebot và index thông thường.</li> </ul> <p>Điểm quan trọng: ba bot của OpenAI là ba thiết lập độc lập. Bạn hoàn toàn có thể mở OAI-SearchBot để được tìm thấy trong ChatGPT search mà vẫn chặn GPTBot.</p> <h2>Lớp 1: đọc robots.txt cho đúng
</h2> <p>Đầu tiên lấy file về:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-s</span> https://example.com/robots.txt </code></pre> </div> <p>Chỗ nhiều người đọc nhầm: một crawler chỉ theo <strong>nhóm user-agent khớp cụ thể nhất</strong> với nó. Nếu file có nhóm <code>User-agent: GPTBot</code> thì GPTBot bỏ qua hoàn toàn nhóm <code>User-agent: *</code>, kể cả các dòng <code>Disallow</code> bạn tưởng là áp dụng cho mọi bot. Ví dụ:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight plaintext"><code>User-agent: * Disallow: /admin/User-agent: GPTBot Disallow: / </code></pre>
</div> <p>Ở đây GPTBot bị chặn toàn site, còn OAI-SearchBot, ClaudeBot, PerplexityBot rơi vào nhóm <code>*</code> nên chỉ bị chặn <code>/admin/</code>. Nếu bạn muốn cho bot tìm kiếm vào nhưng chặn bot huấn luyện, viết rõ từng nhóm:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight plaintext"><code>User-agent: OAI-SearchBot Allow: /User-agent: GPTBot Disallow: /
User-agent: Google-Extended Disallow: / </code></pre>
</div> <p>Mình hay lọc nhanh các dòng liên quan bằng:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-s</span> https://example.com/robots.txt <span class="se">\</span> | <span class="nb">grep</span> <span class="nt">-inE</span> <span class="nt">-A3</span> <span class="s1">'user-agent: *(\*|gptbot|oai-searchbot|chatgpt-user|claudebot|perplexitybot|google-extended)'</span> </code></pre> </div> <p>Hai lỗi mình gặp nhiều nhất: plugin bảo mật hoặc CDN tự thêm nhóm chặn "AI bots" mà chủ site không biết, và robots.txt bị trả về 403 hoặc trang HTML lỗi thay vì file text. Kiểm tra luôn status và content-type:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-sI</span> https://example.com/robots.txt | <span class="nb">grep</span> <span class="nt">-iE</span> <span class="s1">'^(HTTP|content-type)'</span> </code></pre> </div> <p>OpenAI cũng lưu ý thay đổi robots.txt có thể mất khoảng 24 giờ để hệ thống tìm kiếm của họ cập nhật, nên đừng sửa xong rồi thử ngay.</p> <h2>Lớp 2: gọi trang bằng user-agent của bot và xem HTML ban đầu
</h2> <p>robots.txt cho phép không có nghĩa là server cho phép. WAF, Cloudflare hay rule chống bot có thể trả 403, 429 hoặc trang challenge cho đúng mấy user-agent này. Mình giả lập bằng <code>curl</code>:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code><span class="nv">URL</span><span class="o">=</span><span class="s2">"https://example.com/dich-vu/abc"</span><span class="k">for </span>UA <span class="k">in</span> <span class="se"></span> <span class="s2">"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"</span> <span class="se"></span> <span class="s2">"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot"</span> <span class="se"></span> <span class="s2">"OAI-SearchBot/1.4"</span> <span class="se"></span> <span class="s2">"ClaudeBot/1.0"</span> <span class="se"></span> <span class="s2">"PerplexityBot/1.0"</span> <span class="k">do </span><span class="nb">printf</span> <span class="s1">'%-20s '</span> <span class="s2">"</span><span class="si">$(</span><span class="nb">echo</span> <span class="s2">"</span><span class="nv">$UA</span><span class="s2">"</span> | <span class="nb">grep</span> <span class="nt">-oE</span> <span class="s1">'(GPTBot|ChatGPT-User|OAI-SearchBot|ClaudeBot|PerplexityBot)'</span><span class="si">)</span><span class="s2">"</span> curl <span class="nt">-s</span> <span class="nt">-o</span> /dev/null <span class="nt">-A</span> <span class="s2">"</span><span class="nv">$UA</span><span class="s2">"</span> <span class="nt">-w</span> <span class="s1">'%{http_code} %{size_download} bytes\n'</span> <span class="s2">"</span><span class="nv">$URL</span><span class="s2">"</span> <span class="k">done</span> </code></pre>
</div> <p>Chuỗi user-agent đầy đủ có số phiên bản thay đổi theo thời gian; với việc kiểm tra rule chặn theo tên thì chỉ cần chứa đúng tên bot là đủ. Kết quả cần nhìn: mọi dòng nên là <code>200</code> và kích thước gần bằng nhau. Một dòng <code>403</code>, hoặc <code>200</code> nhưng chỉ vài KB trong khi trình duyệt nhận cả trăm KB, thường là trang challenge.</p> <p>Lưu ý: cách này chỉ kiểm tra được rule chặn theo user-agent. Nếu firewall chặn theo IP hoặc ASN thì <code>curl</code> từ máy bạn vẫn qua, còn bot thật thì không. Vì vậy cần lớp 3.</p> <h3>Nội dung có nằm trong HTML ban đầu không
</h3> <p>Nhiều bot AI đọc HTML trả về chứ không chạy JavaScript như trình duyệt. Nếu site là SPA render phía client, bot có thể chỉ thấy một <code><div id="root"></div></code> trống.</p> <p>Cách kiểm tra đơn giản: chọn một câu quan trọng (tên dịch vụ, giá, địa chỉ) và grep trong HTML thô:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-s</span> <span class="nt">-A</span> <span class="s2">"GPTBot/1.4"</span> <span class="s2">"</span><span class="nv">$URL</span><span class="s2">"</span> | <span class="nb">grep</span> <span class="nt">-c</span> <span class="s2">"Dịch vụ thiết kế website"</span> </code></pre> </div> <p>Ra <code>0</code> thì có hai khả năng: nội dung do JS tạo ra, hoặc chuỗi bị encode thành HTML entity. Để chắc, mình bỏ thẻ và xem phần text thô:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-s</span> <span class="nt">-A</span> <span class="s2">"GPTBot/1.4"</span> <span class="s2">"</span><span class="nv">$URL</span><span class="s2">"</span> <span class="se">\</span> | python3 <span class="nt">-c</span> <span class="s2">"import sys,re,html; t=sys.stdin.read(); t=re.sub(r'<(script|style)[^>]*>.*?</</span><span class="se">\1</span><span class="s2">>','',t,flags=re.S); t=html.unescape(re.sub(r'<[^>]+>','</span><span class="se">\n</span><span class="s2">',t)); print('</span><span class="se">\n</span><span class="s2">'.join(l.strip() for l in t.splitlines() if l.strip()))"</span> <span class="se">\</span> | <span class="nb">head</span> <span class="nt">-50</span> </code></pre> </div> <p>Nếu 50 dòng đầu chỉ có menu, footer và "Loading...", đó là dấu hiệu nội dung chính không nằm trong HTML ban đầu. Hướng sửa thường là SSR, SSG hoặc prerender cho các trang quan trọng; tùy framework mà cách làm khác nhau.</p> <p>Cũng nên kiểm tra thêm <code><title></code>, meta description và thẻ <code><meta name="robots"></code> trong HTML thô, vì có site gắn <code>noindex</code> bằng JS rồi quên gỡ:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code>curl <span class="nt">-s</span> <span class="s2">"</span><span class="nv">$URL</span><span class="s2">"</span> | <span class="nb">grep</span> <span class="nt">-oiE</span> <span class="s1">'<(title|meta name="(description|robots)")[^>]*>[^<]*'</span> </code></pre> </div> <h2>Lớp 3: đọc access log
</h2> <p>Đây là nơi trả lời câu hỏi "bot có thực sự ghé không". Với log nginx hoặc Apache dạng combined:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code><span class="c"># Đếm lượt truy cập theo từng bot (gồm cả log đã nén)</span> zgrep <span class="nt">-hoiE</span> <span class="s1">'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot'</span> /var/log/nginx/access.log<span class="k">*</span> <span class="se">\</span> | <span class="nb">sort</span> | <span class="nb">uniq</span> <span class="nt">-c</span> | <span class="nb">sort</span> <span class="nt">-rn</span> </code></pre> </div> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code><span class="c"># Xem bot gặp status nào, ở URL nào</span> <span class="nb">grep</span> <span class="nt">-iE</span> <span class="s1">'GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot'</span> /var/log/nginx/access.log <span class="se">\</span> | <span class="nb">awk</span> <span class="s1">'{print $9, $7}'</span> | <span class="nb">sort</span> | <span class="nb">uniq</span> <span class="nt">-c</span> | <span class="nb">sort</span> <span class="nt">-rn</span> | <span class="nb">head</span> <span class="nt">-30</span> </code></pre> </div> <p>Nếu thấy nhiều <code>403</code> hoặc <code>429</code>, quay lại xem rule WAF hoặc rate limit. Nếu hoàn toàn không có dòng nào sau vài tuần, có thể bot chưa biết tới site, hoặc bị chặn từ tầng CDN trước khi request tới server; khi đó cần xem log hoặc dashboard của CDN.</p> <p>User-agent thì ai cũng giả được. OpenAI công bố dải IP cho từng bot ở các file JSON như <code>https://openai.com/gptbot.json</code>, <code>searchbot.json</code>, <code>chatgpt-user.json</code>. Mình kiểm tra một IP trong log như sau:<br> </p> <div class="highlight js-code-highlight"> <pre class="highlight shell"><code><span class="nv">IP</span><span class="o">=</span><span class="s2">"20.171.206.10"</span> curl <span class="nt">-s</span> https://openai.com/gptbot.json <span class="se">\</span> | jq <span class="nt">-r</span> <span class="s1">'.prefixes[] | .ipv4Prefix // .ipv6Prefix'</span> <span class="se">\</span> | python3 <span class="nt">-c</span> <span class="s2">"import sys,ipaddress; ip=ipaddress.ip_address('</span><span class="nv">$IP</span><span class="s2">'); print(any(ip in ipaddress.ip_network(l.strip()) for l in sys.stdin if l.strip()))"</span> </code></pre> </div> <p>Ra <code>True</code> thì đúng là bot của OpenAI. Với các bot khác, xem trang tài liệu crawler của từng bên để lấy cách xác minh tương ứng.</p> <h2>Checklist ngắn
</h2> <ol> <li>robots.txt trả <code>200</code>, <code>text/plain</code>, không có nhóm chặn bot mà bạn không chủ động thêm.</li> <li>Mỗi bot bạn muốn cho vào được xử lý đúng nhóm user-agent của nó, không trông vào nhóm <code>*</code>.</li> <li> <code>curl</code> với từng user-agent đều ra <code>200</code> và kích thước tương đương trình duyệt.</li> <li>Câu quan trọng nhất của trang có trong HTML thô, không cần JS.</li> <li>Không có <code>noindex</code> ngoài ý muốn trong HTML ban đầu.</li> <li>Log có lượt truy cập từ bot, status chủ yếu là <code>200</code>, IP khớp dải được công bố.</li> <li>Trang đã được Google index, vì AI Overviews chỉ lấy nguồn từ trang đủ điều kiện hiển thị trên Google Search.</li> </ol> <p>Ba lớp này chỉ trả lời câu hỏi bot có đọc được site hay không. Đọc được rồi mà AI vẫn tả sai công ty thì vấn đề nằm ở nội dung và nguồn bên ngoài; phần đó mình đã viết riêng trong <a href="https://manhdigital68.hashnode.dev/checklist-30-ph-t-v-sao-chatgpt-t-sai-c-ng-ty-c-a-b-n" rel="noopener noreferrer">checklist 30 phút tìm lý do ChatGPT mô tả sai doanh nghiệp</a>.</p> <p>Nếu bạn không có quyền đọc log hay không muốn tự mò rule CDN, Mạnh Digital có <a href="https://manhdigital.com/dich-vu/seo-ai" rel="noopener noreferrer">dịch vụ tối ưu cho AI search</a>, trong đó phần kỹ thuật gồm đưa nội dung quan trọng vào HTML ban đầu và cấu hình robots.txt cho các bot AI. Còn nếu tự làm, chạy hết checklist trên một lần là đã loại được phần lớn lỗi mình hay gặp.</p>Original source
Tags
Related Articles
Continue reading with these similar posts

Sources: Missouri RB Hardy, shot in offseason, to return vs. Arkansas
Missouri All-America tailback Ahmad Hardy is set to make his season debut for the Tigers this weekend at Arkansas, sources told ESPN.

Red Wings suspend Larkin as team explores trade options; players keen to move on
The Red Wings announced Thursday that star forward Dylan Larkin has been suspended without pay after informing the team he no longer wanted to play for Detroit.

Packers' Jacobs says TD celebration was ode to gospel song, not mocking arrest
The Packers' Josh Jacobs said he was surprised his first-half TD celebration was perceived by some as mocking his May arrest, saying it was an ode to a gospel song.

Israel faces weeks of coalition haggling as Netanyahu’s party claims election 'stolen'
Israel's election leaves the country facing weeks of coalition bargaining and an uphill battle for the opposition party to form a majority government.
Herdr has released native app
Comments
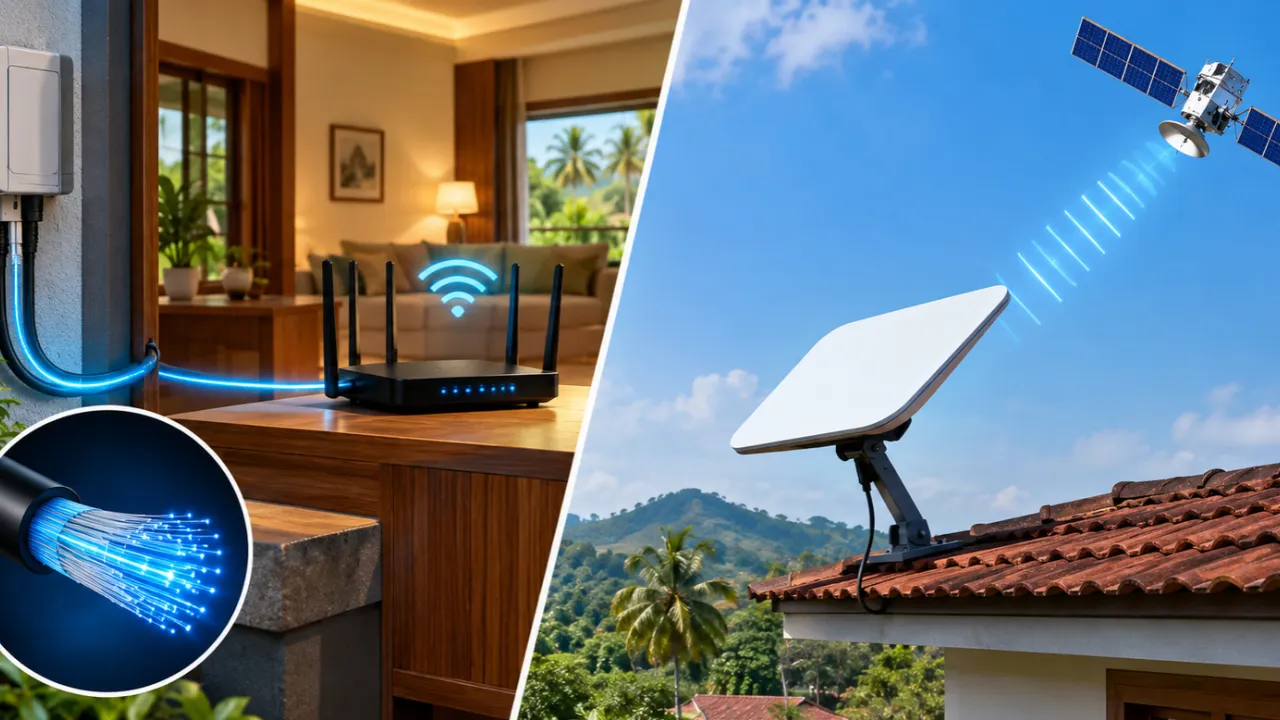
Satellite vs Fiber Internet: ഇന്ത്യയുടെ ഇന്റർനെറ്റ് വിപ്ലവത്തിന് ആര് മികച്ചത്?
ഇന്ന് ഇന്റർനെറ്റ് ഒഴിച്ചുകൂടാനാവാത്ത ഭാഗമായി മാറിക്കഴിഞ്ഞു. ഇപ്പോൾ ഇന്ത്യയിൽ നിലവിൽ ഏറ്റവും ജനപ്രിയമായ ഇന്റർനെറ്റ് മാധ്യമം ഒപ്റ്റിക്കൽ ഫൈബർ (Fiber Internet) ആണ്. എന്നാൽ രാജ്യത്ത് സജീവ ചർച്ചയായി മാറിക്